今回は、Transform Feedbackで頂点間の相互作用が実現できないか粘り強く調査していましたがやはりダメでした。
/(^o^)\オワタ
気分転換に、次回はマンデルブロ集合をTransform Feedbackで高速描画出来ないか考えます。
先週は水分子をTransform Feedbackを利用してFPSをほとんど落とさずにグリグリ動かすことが出来ました。
しかし、私が本当にやりたいことは、水分子が互いに影響を及ぼすような動作です。例えば水の表面張力の、近くの水同士が引っ張り合うような力のシミュレートをしたかったのです。
で、水分子が互いに影響を及ぼすような動作がTransform Feedbackで実現できないか色々調査しましたが、結論としては
他の水分子(座標)の情報は取得できず、水分子同士の相互作用の処理は出来ない
ことが判明しました。
/(^o^)\オワタ
というわけで今後の方針としては
1.CPUをつかって水分子同士の計算を頑張る
2.水分子とか細かい部分はバッサリ切り捨てて単純なゲームを作る。というか分子から作るってどいうこと?いつゲームは完成するの?
3.1と2のバランスを取る
の3つがあるのかなと思います。今週はその方針を考えようと思います。
29日目でCPUにより水分子をグリグリ動かしましたが、今回はシェーダでTransform Feedbackを利用して動かすことが出来ました!
シェーダは以下のように変更しています。
layout (location = 0) in vec3 Position;
layout (location = 1) in vec2 Speed;
out vec3 feedbackPosition;
uniform float pointSize;

void main()
{
    gl_Position = vec4(Position, 1.0);
    float x = Position.x + Speed.x;
    float y = Position.y + Speed.y;
    if (1.0 < x) { x = -1.0; }
    if (x < -1.0) { x = 1.0; }
    if (1.0 < y) { y = -1.0; }
    if (y < -1.0) { y = 1.0; }
    feedbackPosition = vec3(x, y, 0.0);
    gl_PointSize = pointSize;
}
~略~
let c_string = CString::new("feedbackPosition").unwrap();
let c_string_ptr = &c_string.as_ptr();
gl::TransformFeedbackVaryings(program_id, 1, c_string_ptr, gl::SEPARATE_ATTRIBS);
gl::LinkProgram(program_id);
~略~
out vec3 feedbackPositionに、シェーダによる計算結果が格納されます。
位置情報をもう1つ作って、入力と出力用に分けました。
    let mut vertices: Vec<f32> = Vec::with_capacity(POINTS * 3);
    let mut vertices2: Vec<f32> = Vec::with_capacity(POINTS * 3);
    let mut vertices_speed: Vec<f32> = Vec::with_capacity(POINTS * 2);
    let mut rng = rand::thread_rng();
    for _i in 0..POINTS {
        vertices.push(rng.gen_range(-1.0..1.0));    // x
        vertices.push(rng.gen_range(-1.0..1.0));    // y
        vertices.push(0.0);                         // z
        vertices2.push(0.0);    // x
        vertices2.push(0.0);    // y
        vertices2.push(0.0);    // z
        vertices_speed.push(rng.gen_range(-0.01..0.01));    // speed x
        vertices_speed.push(rng.gen_range(-0.01..0.01));    // speed y
    }
描画時に、入力と出力を毎フレーム入れ替えるようにしました。出力結果が次の入力値になるようにし、その際の出力結果は次の入力に・・・と毎回入れ替えながら分子の位置を更新しています。
let mut b_turn: bool = false;

'running: loop {
    ~略~
    // draw points
    unsafe {
        if b_turn {
            gl::BindVertexArray(vao2);
            gl::BindBufferBase(gl::TRANSFORM_FEEDBACK_BUFFER, 0, vbo);
        } else {
            gl::BindVertexArray(vao);
            gl::BindBufferBase(gl::TRANSFORM_FEEDBACK_BUFFER, 0, vbo2);
        }
        // Transform Feedback 開始
        gl::BeginTransformFeedback(gl::POINTS);
        gl::DrawArrays(
            gl::POINTS,     // mode
            0,              // starting index in the enabled arrays
            POINTS as i32,  // number of indices to be rendered
        );
        // Transform Feedback 終了
        gl::EndTransformFeedback();
        // 後片付け
        gl::BindBuffer(gl::ARRAY_BUFFER, 0);
        gl::BindVertexArray(0);
    }
    // swap window
    window.gl_swap_window();
    }
    b_turn = !b_turn;
}
気になるベンチマークですが、
Transform Feedback未使用(CPUで計算)の場合、
1000万ポイント = 28FPS
1億ポイント = 3FPS
Transform Feedback 使用(シェーダで計算)の場合、
1000万ポイント = 60FPS
1億ポイント = 20FPS
となり、大幅な性能向上を果たしました。なんとこれ、分子を動かす前とFPS値がほぼ変わって無いです。Transform Feedbackにより、余って無駄になっていたGPUリソースを有効活用できました。
( ✌’ω’)✌
昨日は水分子を、画像を使わずにシェーダのみで描画するように変更しました。
今日は水分子を、空気中を飛び回っているイメージでグリグリ動かしました。
コードの変更箇所は以下の通りです。
let mut vertices: Vec<f32> = Vec::with_capacity(POINTS * 3);
let mut vertices_speed: Vec<f32> = Vec::with_capacity(POINTS * 2);
let mut rng = rand::thread_rng();
for _i in 0..POINTS {
    vertices.push(rng.gen_range(-1.0..1.0));    // x
    vertices.push(rng.gen_range(-1.0..1.0));    // y
    vertices.push(0.0);                         // z
    vertices_speed.push(rng.gen_range(-0.01..0.01));    // speed x
    vertices_speed.push(rng.gen_range(-0.01..0.01));    // speed y
}
// move points
for i in 0..POINTS {
let base_pos = i * 3;
let base_speed = i * 2;
// x方向
if 1.0 < vertices[base_pos + 0] || vertices[base_pos + 0] < -1.0 {
vertices_speed[base_speed + 0] *= -1.0;
}
vertices[base_pos + 0] += vertices_speed[base_speed + 0];
// y方向
if 1.0 < vertices[base_pos + 1] || vertices[base_pos + 1] < -1.0 {
vertices_speed[base_speed + 1] *= -1.0;
}
vertices[base_pos + 1] += vertices_speed[base_speed + 1];
}
unsafe {
    gl::BindBuffer(gl::ARRAY_BUFFER, vbo);
    gl::BufferData(
        gl::ARRAY_BUFFER,                                                       // target
        (vertices.len() * std::mem::size_of::<f32>()) as gl::types::GLsizeiptr, // size of data in bytes
        vertices.as_ptr() as *const gl::types::GLvoid, // pointer to data
        gl::STREAM_DRAW,                               // usage
    );
    gl::BindBuffer(gl::ARRAY_BUFFER, 0);
}
// draw points
unsafe {
gl::BindVertexArray(vao);
gl::DrawArrays(
gl::POINTS, // mode
0, // starting index in the enabled arrays
POINTS as i32, // number of indices to be rendered
);
}unsafe {
gl::BindBuffer(gl::ARRAY_BUFFER, vbo);
gl::BufferData(
gl::ARRAY_BUFFER, // target
(vertices.len() * std::mem::size_of::<f32>()) as gl::types::GLsizeiptr, // size of data in bytes
vertices.as_ptr() as *const gl::types::GLvoid, // pointer to data
gl::STREAM_DRAW, // usage
);
gl::BindBuffer(gl::ARRAY_BUFFER, 0);
}Rustのコード上で描画位置を変更していますが、これだとポイント数が増えた場合に負荷がヤバそうです。
明日からはなるべくシェーダに仕事をさせられないか検討します。
昨日に引き続き、今日は円の半径に伴いアルファ値が変わるようにシェーダを調整しました。
#version 330 core

out vec4 Color;

void main()
{
    vec3 target;

    target.xy = (gl_PointCoord - 0.5) * 2.0;                // 座標値変換 (0, 1) -> (-1, 1)
    float r2 = target.x * target.x + target.y * target.y;   // 半径の2乗
    if (1.0 < r2) {
        discard;
    }
    Color = vec4(0.0f, 0.0f, 1.0f, 0.4 * (1.0 - r2));
}これだけですが効果は抜群で、水分子画像を使わずにシェーダだけで事が済んでしまいました。むしろ水分子画像を拡大したときはシェーダの方が綺麗に描画できます。
そして気になるパフォーマンスですが、画像を使わずにシェーダだけで描画したほうが、1FPSだけですが上回りました。(1億と1000万ポイント描画時に計測)
せっかくGIMPで一生懸命?作りましたが、シェーダ方式を採用することにしました。透明度や色、様々なエフェクトなどシェーダの方が自由度も高いですしね。
昨日はMacでも開発できるよう環境を整えました。
本日は水分子を画像を使わずにシェーダで描画するようにしてみます。まずポイントスプライトを円形にするため、フラグメントシェーダを以下のように改変しました。
#version 330 core

out vec4 Color;

void main()
{
    vec3 target;
    // 座標値変換 (0, 1) -> (-1, 1)
    target.xy = (gl_PointCoord - 0.5) * 2.0;
    // 半径の2乗
    float r2 = target.x * target.x + target.y * target.y;
    if (1.0 < r2) {
        discard;
    }
    Color = vec4(0.0f, 0.0f, 1.0f, 0.3f);
}
円外の場合はdiscardで色を付けないようにしています。結果は以下のようになりました。
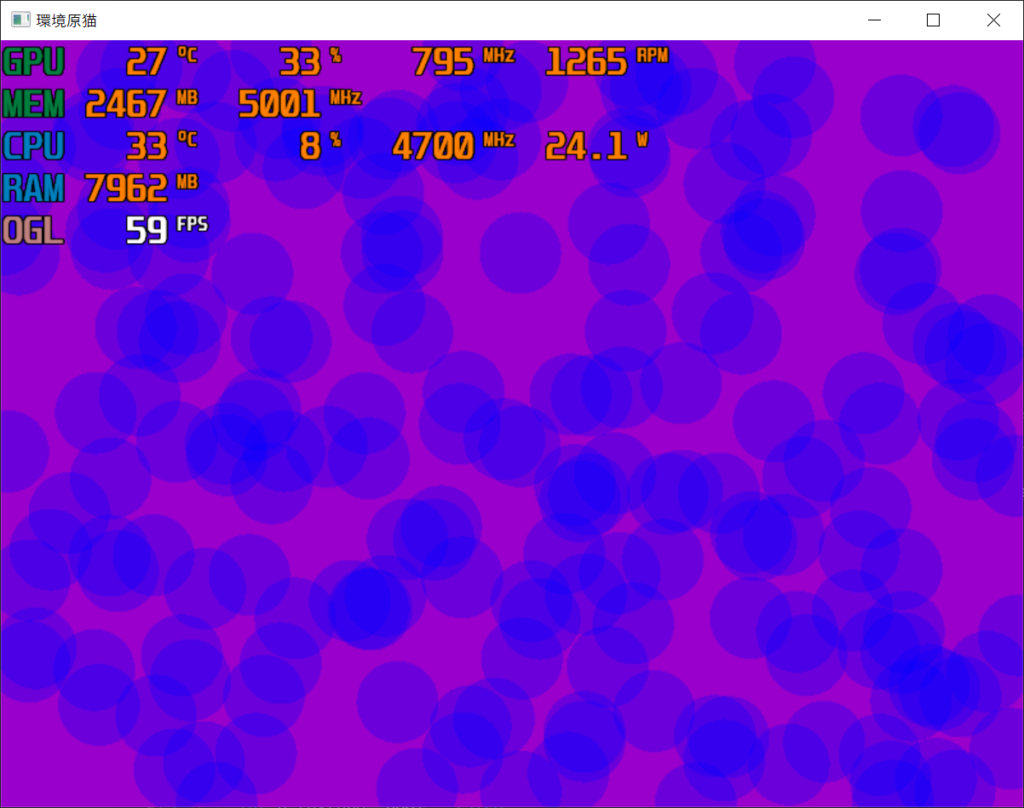
明日はアルファ値を調整します。
本日は昨日に引き続き、Macにおける開発環境を整えるため、VSCodeに「rust-analyzer」「CodeLLDB」「Shader languages support for VS Code」の3つの拡張機能を入れました。
また、FPS計測ロジックを実装し、Macで
1億個のポイントスプライト
を描画して何FPS出るか確認しました。
FPS計測ロジックは以下のような実装です。
const B_FPS: bool = true;           // FPS 表示フラグ
let mut draw_count_for_fps = 0;
let mut start_for_fps = Instant::now();

const B_LIMIT_60FPS: bool = true;   // 60FPS制限フラグ
let time_for_wait = 1_000_000_000u32 / 64;  // 60 で割ると60FPS出ないので余裕を持たせておく
let mut start_loop = Instant::now();

’running: loop {
    if B_LIMIT_60FPS {
        start_loop = Instant::now();
    }
    ~描画処理省略~
    // swap window
    window.gl_swap_window();
    // calc fps
    if B_FPS {
        draw_count_for_fps += 1;
        let time_for_fps_ms = start_for_fps.elapsed().as_millis();
        if 1000 <= time_for_fps_ms {
            println!("{:.2} FPS", (draw_count_for_fps as f64 * 1000.0) / time_for_fps_ms as f64);
            draw_count_for_fps = 0;
            start_for_fps = Instant::now();
        }
    }
    if B_LIMIT_60FPS {
        let time_nanos: u32 = start_loop.elapsed().as_nanos() as u32;
        //println!("{}ナノ秒経過しました。", time_nanos);
        if time_nanos < time_for_wait {
            //println!("{}ナノ秒待機しました。", time_for_wait - time_nanos);
            ::std::thread::sleep(::std::time::Duration::new(0, time_for_wait - time_nanos));
        }
    }
}
1億個描画した結果は
Windows(9900K + RTX3070)では20FPS
Mac(M1)では1FPS未満
でした。
ちなみに1000万個の場合、
Windows(9900K + RTX3070)では60FPS張付き
Mac(M1)では8FPS
でした。
昨日はシェーダを調整しました。
今日はMacでも開発できるように環境を整えました。
※あくまで開発環境であり、ゲームをMacに対応させるつもりはありません。
※以下手順は、MacにGit/Rust/Homebrewがインストール済みの前提です。
まず、昨日までWindows環境で開発していたソースをgithubから持ってきます。
git clone https://github.com/あなたのソースパス
次に、SDLのライブラリをHomebrewでインストールします。
brew install sdl2
インストールしたライブラリへパスを通すため、.zshenvに以下を追記します。
export LIBRARY_PATH="$LIBRARY_PATH:$(brew --prefix)/lib"Homebrewがインストールされているパス(brew –prefix)は、以下のコマンドで分かります。
brew --prefix
で、最後にgit cloneでソースを持ってきたパスに移動してcargo runを実行します。
thread ‘main’ panicked at ‘called `Result::unwrap()` on an `Err` value: “Failed creating OpenGL context at version requested”‘, src/main.rs:45:43
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
エラーが出てしまいました。
「要求されたバージョンでOpenGLコンテキストの作成に失敗しました。」というエラーのようです。
わたしはM1のMacを使ってますが、この場合OpenGLのサポートは4.1までのようです。
そこでOpenGLのバージョン指定を4.5から4.1に変更したら成功しました。
gl_attr.set_context_version(4, 1); // Set the OpenGL context version
〜略〜
debug_assert_eq!(gl_attr.context_version(), (4, 1));
VSCodeはMac上でも使えます。
これでWindowsでもMacでも開発可能になりました。
うれし〜〜😍
(੭ ˃̣̣̥ ω˂̣̣̥)੭ु⁾⁾